新一代视频模型。从镜头开始。
RayWorld 的全模态能力覆盖:文生视频(T2VA)、首帧 / 尾帧(FL2VA)、全能参考(Ref2VA),以及参考音频;出片可选择带声音。在此之上,相机几何作为原生输入:指定位姿与角度即可生成新视角,场景很少跑偏。
八条覆盖四种相机运动:进入后回望、行进中转向、绕锁定主体、贴身追击。点选静帧即可跳转。
相机可控生成
参考图构成空间上下文,相机路径指定位姿。路径怎么走,场景很少跑偏。以下三条均为沿设计路径进入已锁定场景。
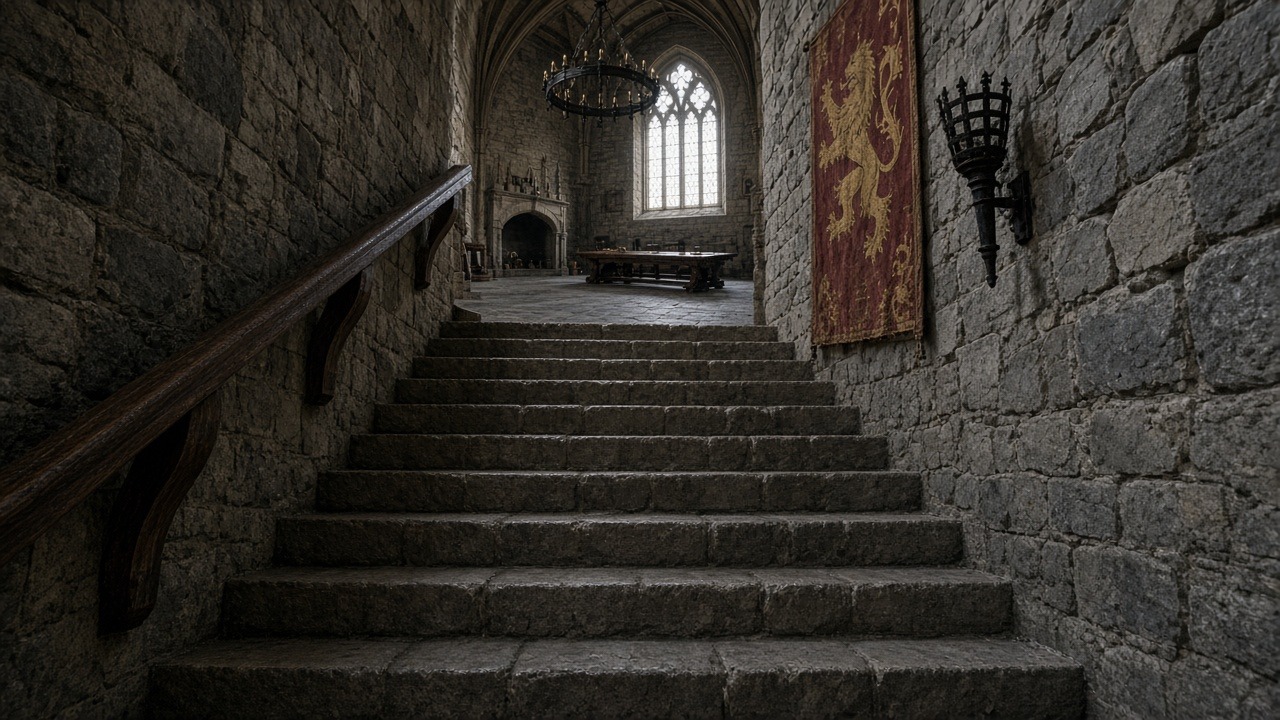
古堡楼梯
一条楼梯、两张参考。上去进入大厅,再沿原路往下看。评的是:回头时狮纹旗还在火把左边,没有另造一座楼梯。
两张参考把一座楼梯钉死:一张是从底部往上看、大厅已经在尽头;一张是从顶部回望。镜头一条走完,回来仍是同一面墙、同一面旗、同一把火把。
提示词第一人称走进这座古堡。从楼梯底部往上走,到达大厅后绕长桌看一圈,再回头沿同一条楼梯往下望。狮纹旗始终在火把左边。无人。
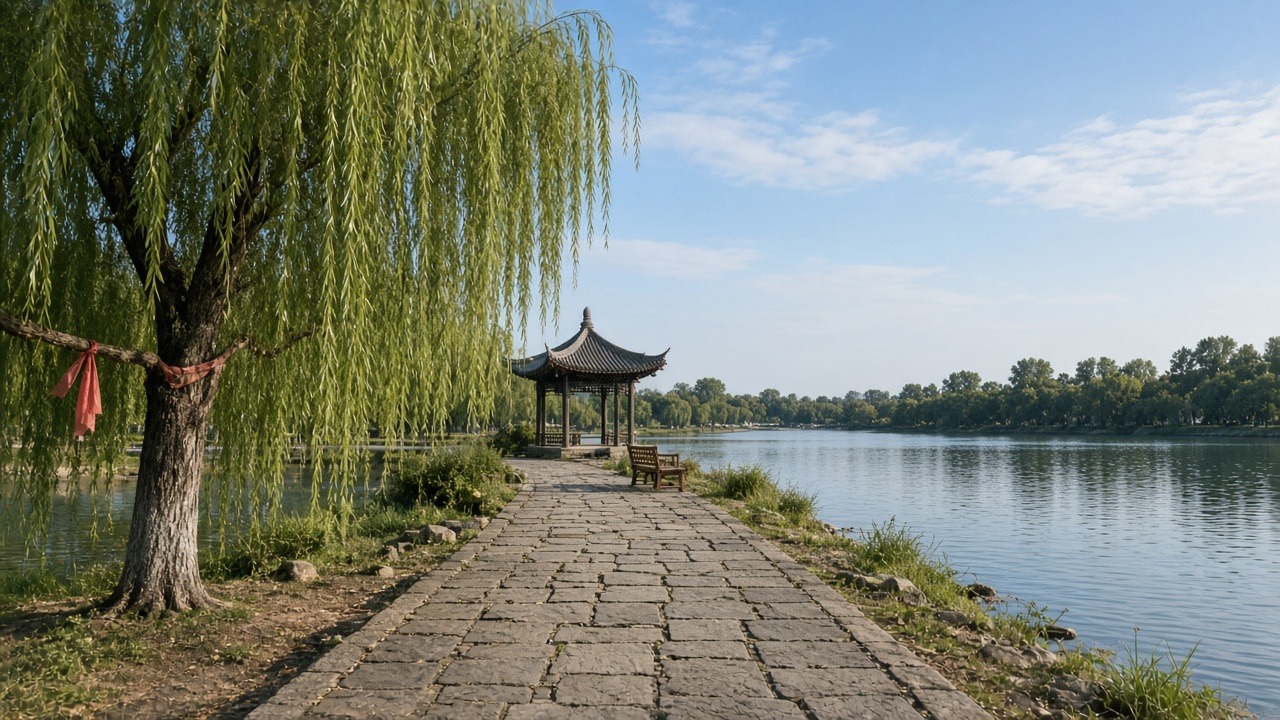
湖边石径
只用一张湖边公园。走到尽头那座灰瓦亭,绕看,再沿同一条石径回来。红飘带柳换到右侧,园子没有换。
一张底图锁住整座公园:柳、石径、亭、凳、湖。走到尽头再回头,红飘带柳换到右侧,路还是这条路,没有切到另一座园子。
提示词第一人称沿湖边石板路往前走。左边一棵系着红飘带的柳,尽头是灰瓦六角亭和一条木凳。走到亭边绕看,再沿原路回头。白天,无人。
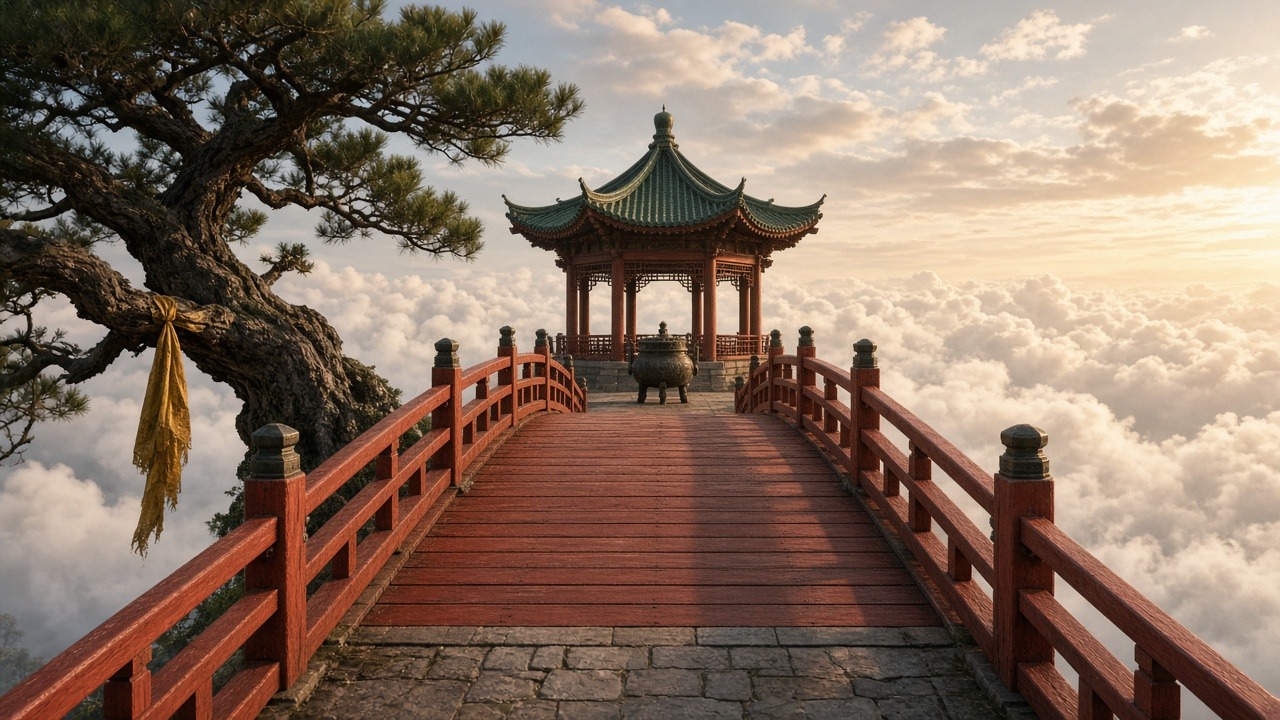
云海朱桥
同一类「走进空间」,换一条看法:人沿桥往前,机位朝向云海。亭从左侧出画,再从右侧入画。
路径沿桥往前。走的过程里视线已经对着云海,不是停在亭前再转头。亭还是这座亭,云海里不长出第二座庙。
提示词第一人称走过这座朱红木桥。左边一棵挂着黄符的松,桥尽头是绿琉璃飞檐的六角亭。走到亭前停下,原地环视四周云海。不要再往前走,不要原路折返。无人。
同一场景
输入越多,想象越少。场地一张、主体一张,必要时再加一张「之后」的状态。更换相机位姿或冻结时间,物体计数不能增加。
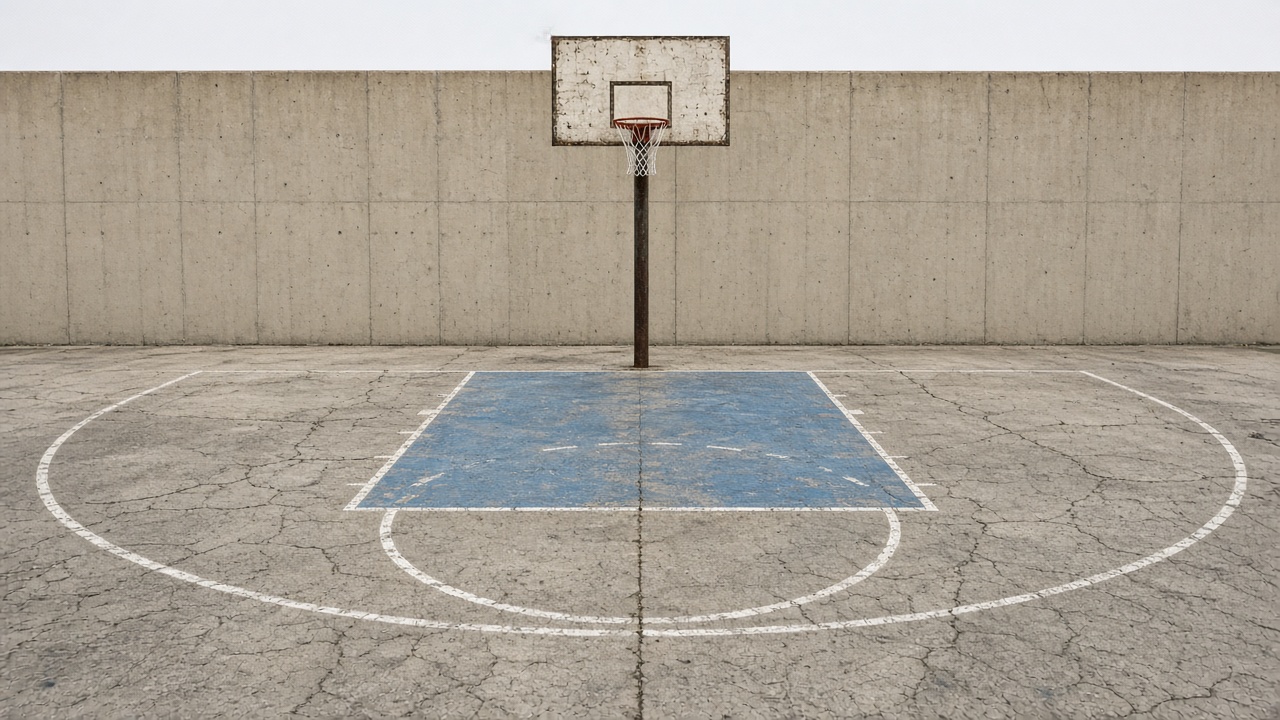
空场篮球
半场和篮球分开锁。球先停在筐前当锚点,相机绕一周,再让同一只球入网。绕的不是飞行中的球,背景也不许长出第二套筐。
两张参考分别锁场地和球。中段绕的是悬停锚点,不是跟踪飞行中的球。绕完再入网,半场、墙、筐始终是同一套。
提示词户外简陋半场,无人。一只橙色篮球悬停在唯一篮筐前方斜上方。相机绕球一周,然后这只球飞入该筐落下。不要第二套球架,不要树,不要人。
草莓入奶
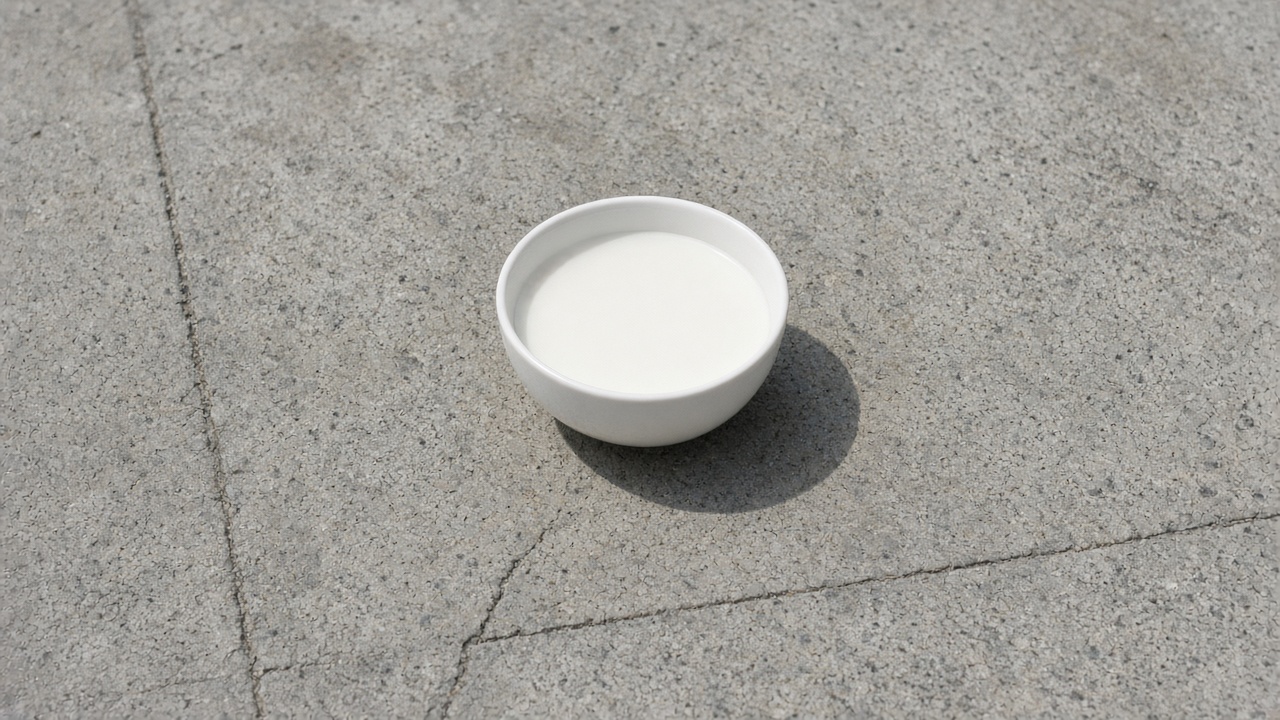
空碗、草莓、溅起后的同一只碗。果落入后时间冻住,相机只换看法。全片一只草莓、一只碗。
三张参考分别是空碗、草莓身份、溅起后的同一只碗。冻住之后只换看法,不再解冻,也不再长出第二只果。
提示词白天水泥地上一只白碗牛奶。一只草莓从高处落入碗中,溅起大约半碗奶。时间在最高点冻住,相机绕碗转 120 度。只有一只草莓、一只碗。
西瓜碎裂
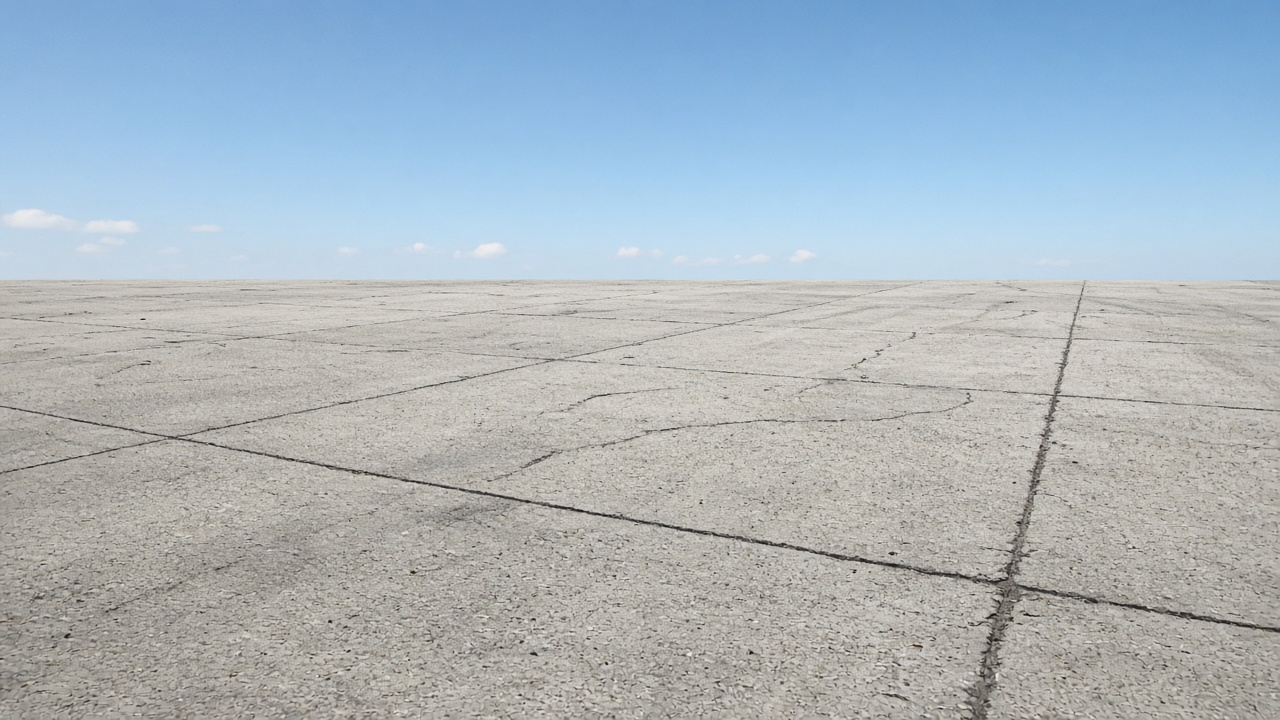
和草莓同一套时间逻辑。整瓜砸开后被碎裂状态替换,不是旁边再摆一只。绕 360 度,地面仍是那块水泥。
和草莓同一套时间逻辑,换一种物。整瓜在撞击后被碎开的状态替换,不是旁边再摆一只。绕 360 度,地面仍是那块水泥。
提示词白天空旷水泥地。一只绿纹西瓜从高处砸下,爆开后时间冻住。相机绕碎开的瓜转一圈。全片只有这一只瓜,爆开后不要再出现整瓜。
时间冻结与重取景
时间可以冻结,也可以继续流动。关键是从新视角回来仍在同一场景:箱子、桶、炸点、机库不能换边,更不能另起一处。
水泥靶场
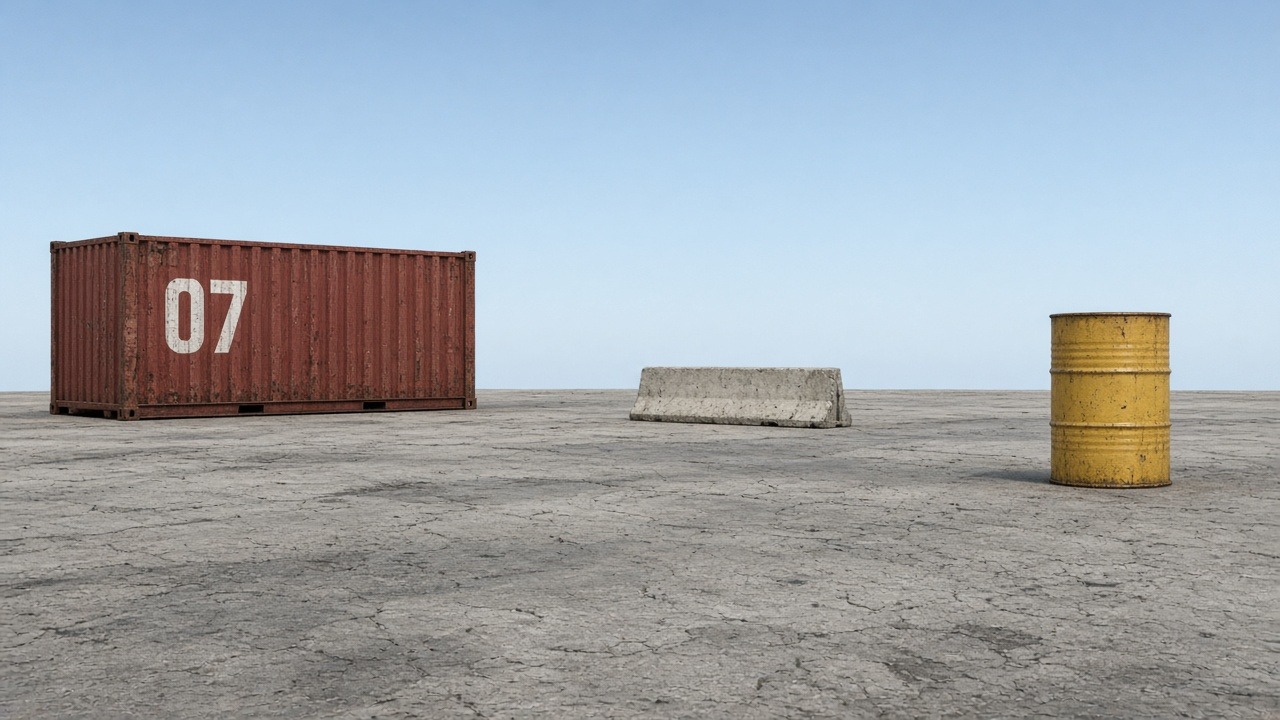
第一人称一直开火。扫一眼左边 07 箱、右边黄桶,再回到正中同一道墩。爆炸只打在这一个点上。
三张参考锁场地、枪、爆炸位置。转头看左右再回来,07 箱仍在左、黄桶仍在右、火球仍在那一道墩,不是另造一片战场。
提示词第一人称站在白天水泥场。左手一只写着 07 的红集装箱,正中一道防撞墩,右手一只黄油桶。一直向正中那道墩射击,爆炸只打在墩上。扫一眼左边箱子和右边桶,再回到同一道墩。无人。
机背追击
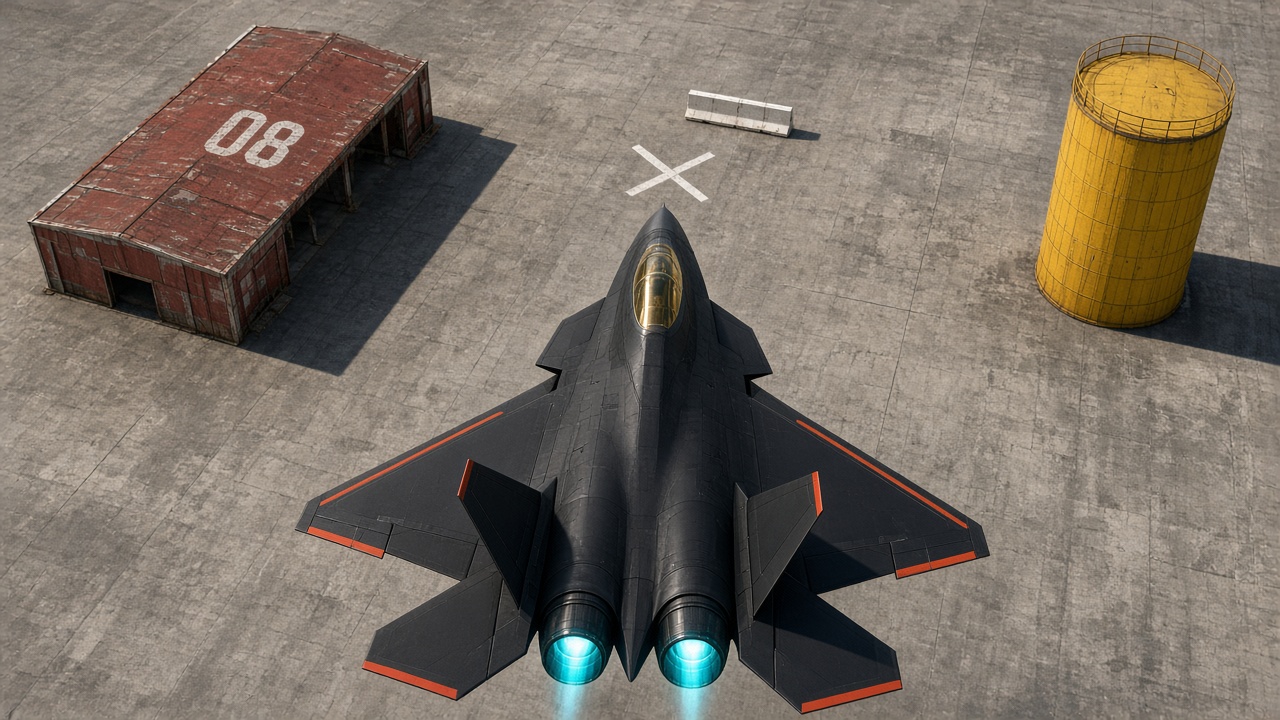
镜头粘在机背上往下打。飞机往前飞,机库和黄罐因为飞过而滑走,炸点仍锁在地面那个 X。
机位跟飞机走,不是切到卫星图。地面目标锁在同一个 X。机库和罐子因为飞过而滑出画面,不是瞬移到另一座机场。
提示词第三人称追逐镜头贴在一架黑橙隐身战斗机背上,从机背往下看。飞机向前飞,持续射击地面那个白色 X。爆炸只打在这个标记上。左侧一座 08 机库,右侧一只黄罐。不要第二架飞机。
全模态生成
文生视频、首帧 / 尾帧、参考图 / 参考视频 / 参考音频均可独立使用,也可与相机路径叠加。这不是只做文生视频的模型。
第一人称沿湖边石板路往前走。左边一棵系着红飘带的柳,尽头是灰瓦六角亭和一条木凳。走到亭边绕看,再沿原路回头。白天,无人。
模型原理
RayWorld 做全模态生成,并给当前镜头加上精准的视线:镜头所到之处,空间对得上,视频也对得上。
只算看见的
不给整屋做全量仿真。镜头对着椅子,就只算这把椅子所在的视线。
视线是硬约束
相机路径先编译成和画面格子对齐的视线场,再叠进注意力。
相机几何是原生输入
相机位姿进入模型,而不是写在提示词里的粗粒度指令。
输出是视频
先锁定场景,再按相机路径生成。视频可播放,场景保持一致。
视线体系
全量三维仿真会为场景里的每把椅子建立完整几何,再把整屋算一遍——拍不到的区域也在算。如果只要一个角度的视频,庞大计算量里只有极小一部分有效。
RayWorld 只算镜头正在看的那一层。视线指向哪里,场景就在哪里成立。多人、多座椅、黑板墙上的字,都跟着这条视线走,而不是每次重赌下一帧。
这也是它和常见 DiT 视频模型的差别。没有几何约束时,「场景要稳」只是一句散文;镜头一转,人会飘,桌子会搬家,墙上的字会丢。
训练:每个视觉 Token 带上视线
训练时,每个视觉 Token 除了格子编号,还带视线参数,让注意力能读「这条视线指向哪里」。这是一次几何适配,增加的权重很小,全模态能力不被拆掉。
DiT 训出来的权重没有几何约束。推理时空间对错几乎推不动注意力,所以稳定性往往是随机的。
推理:相机路径先编译成视线场
推理时,相机路径先编译成一份和画面格子对齐的视线场,再叠进注意力——等于告诉模型:现在正沿着这条路径看。这是硬约束,相当于给镜头加上 6D 物理坐标。
剧烈晃动、360 度转头,模型关注的仍是当前视线。算力消耗和 DiT 接近,但空间是锁住的:镜头转到左侧墙,黑板上的字还在。
接入 RayWorld
内测以白名单开放。写明生成需求,审核通过后进入控制台,使用全模态输入与四种相机模式。